Durante treinta años, integrar datos ha significado lo mismo: copiarlos de un sitio a otro. El ETL los extrae y los recarga en un almacén, el ESB los hace transitar por un hub central, el data lake los vuelca todos en el mismo lugar « por si acaso ». Tres generaciones de herramientas, un solo reflejo: capturar, duplicar, almacenar. Pero en 2026 el dato se ha vuelto tiempo real, distribuido y regulado. Y el viejo postulado de « almacenar para integrar » se paga ahora en latencia, en costes ocultos y en superficie de ataque.
ETL, ESB, Data Lake: tres respuestas, un mismo postulado
Los tres pilares históricos de la integración responden al mismo problema, en épocas distintas. El ETL (Extract, Transform, Load) nació con los almacenes de datos: extrae el dato de los sistemas de origen, lo transforma y luego lo recarga en una base central, casi siempre de noche, por lotes. El ESB (Enterprise Service Bus) generalizó el hub de integración: un bus central por el que todo transita, con sus colas de mensajes y sus copias intermedias. El data lake, por último, llevó la lógica al extremo: volcar la totalidad de los datos en bruto en un único depósito, apostando a que ya se sabrá explotarlos más adelante.
El punto en común salta a la vista: en los tres casos, para hacer circular el dato, se empieza por copiarlo y dejarlo en algún sitio. Este mercado sigue siendo enorme y creciente. La integración de datos representaba 17.580 millones de dólares en 2025 y debería alcanzar los 33.240 millones en 2030, es decir, un crecimiento anual del 13,6 % (fuente: MarketsandMarkets). Pero dentro de este mercado, el centro de gravedad se desplaza.
El segmento que se dispara es la integración en cloud y en tiempo real. El mercado del iPaaS (Integration Platform as a Service) superó los 9.000 millones de dólares de ingresos en 2024, frente a los 7.800 millones de 2023 y los 5.900 millones de 2022, y Gartner prevé que rebase los 17.000 millones de aquí a 2028 (fuente: Gartner, vía Informatica). A modo de comparación, el conjunto del mercado del middleware aplicativo creció un 11,9 % en 2024 hasta alcanzar los 64.100 millones de dólares (fuente: Gartner): la integración moderna crece aproximadamente el doble de rápido que el middleware clásico. La dirección es clara, incluso cuando las viejas herramientas siguen en su sitio.
El batch ya no aguanta: el dato se ha vuelto tiempo real
El modelo ETL se apoya en una hipótesis que ha dejado de ser cierta: que el dato puede esperar. Pero ya no espera. IDC estimaba que el volumen mundial de datos pasaría de 33 zettabytes en 2018 a 175 zettabytes en 2025, y sobre todo que cerca del 30 % de ese dato debería consumirse en tiempo real (fuente: IDC, Data Age 2025). Un dato que se decide al segundo encaja mal con un procesamiento nocturno por lotes.
Este dato no solo es más rápido, también está en otra parte. Gartner ya preveía en 2018 que el 75 % de los datos de empresa se crearían y procesarían fuera de un centro de datos centralizado o de un cloud tradicional de aquí a 2025, frente a alrededor del 10 % de entonces (fuente: Gartner). Arrastrar mecánicamente todo ese dato hacia un almacén central para procesarlo se convierte en un sinsentido geográfico tanto como económico.
El mercado valida este vuelco. La analítica en streaming, es decir, el procesamiento del dato mientras circula, debe pasar de 29.530 millones de dólares en 2024 a 125.850 millones en 2029, es decir, un crecimiento anual del 33,6 % (fuente: MarketsandMarkets). Sobre el terreno, más del 80 % de las empresas del Fortune 100 ya utilizan Apache Kafka para hacer circular sus flujos en modo orientado a eventos (fuente: Apache Kafka). Y la presión sigue subiendo: Gartner prevé que la adopción del streaming de datos para la IA agéntica superará el 60 % de aquí a 2028, frente a menos del 15 % en 2025 (fuente: Gartner).
La brecha entre el valor percibido y la realidad sigue siendo, sin embargo, enorme. Una encuesta realizada para Solace mostraba que el 85 % de las organizaciones reconocen el valor de negocio de la arquitectura orientada a eventos, pero que solo el 13 % considera haber alcanzado su plena madurez (fuente: Coleman Parkes para Solace). El tiempo real se entiende y se desea. Lo que falta es una forma de alcanzarlo sin reconstruir un almacén más.
El data lake, del depósito al pantano
El data lake prometía resolver el problema eliminando los silos: un solo lugar para almacenarlo todo, y ya se verá más adelante. Gartner ya había advertido en 2014 con su « data lake fallacy »: sin metadatos descriptivos ni gobernanza, un lago de datos se transforma en « data swamp », un pantano donde la información existe pero se vuelve imposible de encontrar e inexplotable (fuente: Gartner).
Diez años después, el diagnóstico se confirma en las cifras. El dato almacenado sigue estando, en gran medida, inactivo.
- El 55 % de los datos de una organización son « dark data »: existen, pero no se encuentran, ni se preparan, ni se analizan (Splunk, The State of Dark Data)
- El 68 % de los datos de los que disponen las empresas no se explotan nunca, según una encuesta realizada a 1.500 directivos (Seagate e IDC, Rethink Data)
- Entre el 60 y el 73 % del conjunto de los datos de una empresa permanecen sin utilizar para la analítica (Forrester)
El problema no es el volumen, es la gobernanza de todo lo que duerme. Gartner predice, de hecho, que el 80 % de las iniciativas de gobernanza de los datos y de la analítica fracasarán de aquí a 2027 (fuente: Gartner). Acumular nunca ha sido sinónimo de explotar. Cuanto más crece el depósito, más cuesta mantenerlo, asegurarlo y gobernarlo, para una fracción de valor realmente utilizada.
Lo que cuesta de verdad el desplazamiento de los datos
Copiar y almacenar no es neutro, ni en lo financiero, ni en materia de riesgo. Cada copia que abandona un cloud se factura: la transferencia de salida estándar de AWS arranca en 0,09 dólares por gigabyte por encima de los 100 GB gratuitos mensuales (fuente: AWS). Anodino por unidad, este coste se vuelve estructural a escala: Gartner estima que la mayoría de los clientes destinan entre el 10 y el 15 % de su factura cloud solo a los gastos de egress (fuente: Gartner, vía Fierce Network). Sobre un gasto mundial en cloud público previsto en 723.400 millones de dólares en 2025 (fuente: Gartner), la cuenta da vértigo. El legislador ha tomado cartas en el asunto: el Data Act europeo suprimirá por completo los gastos de cambio de proveedor, gastos de egress incluidos, a partir del 12 de enero de 2027 (fuente: Comisión Europea).
El coste oculto más peligroso no está, sin embargo, en la factura, está en el riesgo. Cada copia es un objetivo más. El informe de IBM sobre el coste de las brechas de datos indica que el 35 % de las fugas implican « shadow data », esos datos duplicados fuera del perímetro de seguridad, y que esas brechas cuestan de media un 16 % más caras (fuente: IBM, Cost of a Data Breach 2024). Sabiendo que el coste medio mundial de una brecha alcanzó un máximo de 4,88 millones de dólares en 2024 (fuente: IBM), cada réplica inútil se convierte en una deuda de seguridad.
Queda la soberanía. Los tres gigantes estadounidenses concentran el 70 % del mercado cloud europeo, mientras que la cuota de los proveedores europeos ha caído a alrededor del 15 % (fuente: Synergy Research Group). Pero muchas herramientas de integración e iPaaS son servicios estadounidenses, sujetos al Cloud Act. En su evaluación jurídica conjunta, el EDPB y el EDPS concluyen que, a falta de un acuerdo internacional, un proveedor sujeto al derecho de la Unión no puede transferir legalmente datos hacia Estados Unidos sobre la base de tales solicitudes, en contradicción directa con el artículo 48 del RGPD (fuente: EDPB y EDPS). Hacer transitar los datos por un hub de integración estadounidense es exponer cada byte copiado. Como ya explicábamos a propósito de la soberanía digital, la nacionalidad del proveedor prima sobre la localización de los servidores.
La orquestación en tránsito: integrar sin almacenar
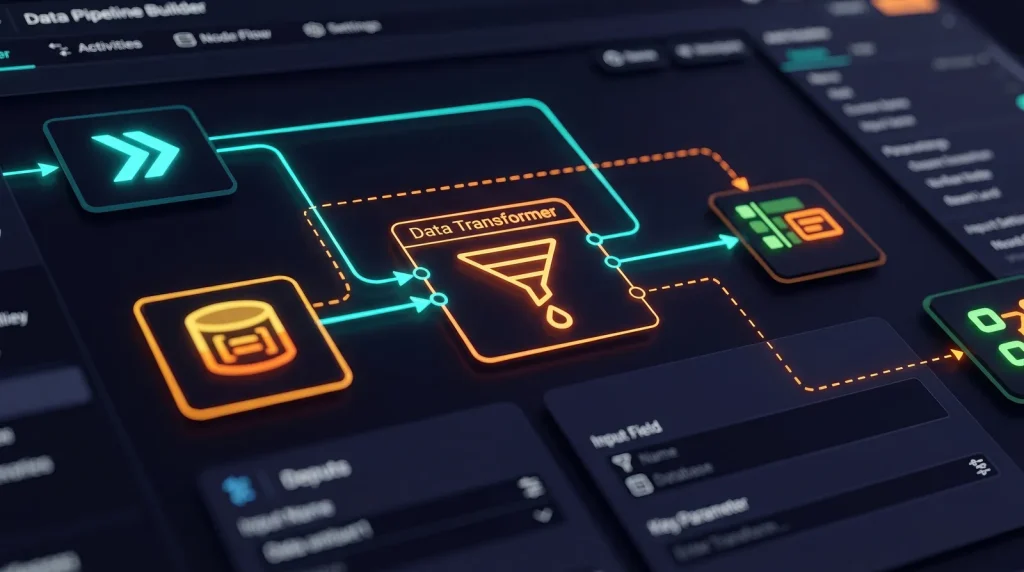
Si copiar y almacenar es el origen del problema, la solución consiste en dejar de hacerlo. Es el principio de la orquestación en tránsito: procesar el dato mientras circula, en el momento preciso de su paso, sin posarlo ni duplicarlo jamás. El dato ya no se aspira hacia un depósito central, se transforma al vuelo y luego se libera hacia su destino.
Es el enfoque de iD4Connect. Cada DataCell es una unidad de procesamiento autónoma que limpia, transforma, enriquece, anonimiza o enruta el dato durante su tránsito, y luego no guarda nada. La orquestación de estos DataCells, organizada en DataGraph, permite construir flujos complejos entre cualquier aplicación, on-premise, en cloud o en híbrido. El Conector Universal se encarga de la ingesta a través de todos los protocolos estándar (REST, SQL, MQTT, Kafka, OPC-UA, SFTP…), sin imponer su propio formato.
El beneficio es triple. La superficie de exposición cae a cero, ya que ningún dato se almacena de paso. La soberanía está garantizada por diseño, al estar la arquitectura concebida en Europa y ejecutada dentro del perímetro del cliente. Y el coste se vuelve previsible, sin almacén que mantener ni egress que pagar por copias que nadie utiliza. Allí donde el ETL, el ESB y el data lake añaden una capa de almacenamiento entre sus sistemas, la orquestación en tránsito la suprime. Para profundizar, detallamos nuestro posicionamiento frente a las herramientas existentes.
El ETL, el ESB y el data lake no han fracasado: resolvieron los problemas de su época. Pero aquella época suponía un dato lento, centralizado y poco regulado. En 2026 el dato es rápido, está en todas partes y bajo vigilancia jurídica. La verdadera pregunta ya no es « dónde almacenar para integrar », sino « cómo integrar sin almacenar ». Y la mejor copia sigue siendo la que nunca se hizo.
Descubra cómo iD4Connect orquesta sus datos sin almacenamiento intermedio →